从零学习 Tokenizer → Transformer → 0.1B → Agent:逐步实操版
适用对象:第一次接触模型训练的人。先在这台 Windows 电脑完成 CPU 教学版,再租 NVIDIA GPU 做 Triton、0.1B 和多卡实验。所有命令均从项目目录 I:\sideprojects\ai fundamental 执行。每一步都写出「入口 → 输入 → 输出 → 验收」。不要一次粘贴整篇;完成一站再继续。
先回答你最关心的三件事
- CUDA 测试到底怎样? 本机最新运行
pytest显示18 passed, 1 skipped。被跳过的是 GPU/Triton 参数化测试文件,因为本机只有 Intel HD Graphics 530,没有 NVIDIA CUDA;本机没有任何 CUDA 测试通过。租赁的 RTX 4090 上另行运行python -m pytest -q tests/test_triton_attention.py已看到6 passed,说明 kernel 的这些形状通过数值对照。通过也不代表更快,速度要另测。 - 能和模型聊天吗? 可以用终端界面
fundamental.chat输入一句、生成一句。当前runs/chat_toy.pt是约 111 万参数的玩具模型,用 4 句问答做过 200 步 SFT:它能复述训练过的回答,遇到新问题常胡说。它不是通用聊天助手。 - 什么是 interface(接口)? 这里有三层:① 终端命令行接口(CLI),例如
python -m fundamental.train --data tokens ...;② 文件接口,例如 JSONL 输入、.bintoken 文件、.ptcheckpoint 输出;③ Python 函数接口,例如GPT.forward(ids)输入整数 token 张量、输出 logits。聊天入口是终端,不是网页或 API 服务。
一、全流程地图
原始文档 JSONL
  ↓ 清洗/去重/分割
clean/train.jsonl, val.jsonl, test.jsonl
  ↓ 只用 train 训练 tokenizer
tokenizer.json
  ↓ 把三个 split 编成 token ID
tokens/train.bin, val.bin, test.bin
  ↓ 训练 Transformer
runs/.../base.pt + metrics.jsonl
  ↓ 共用 base,做 SFT;再从同一 SFT 分叉 DPO / RLVR
各阶段 .pt + 评测 JSON
  ↓ Agent 环境:生成 action → verifier 判定 → 记录轨迹
成功率/成本 → report/neurips_style.md
一个 token 是模型处理文本的单位,可能是一个字节、词片段或标点;不是一个汉字,也不一定是一个单词。模型只看到整数 ID。训练时让模型预测下一 ID,推理时重复「预测一个 → 接到末尾 → 再预测」。
二、术语表:全称、中文和在本项目中的含义
| 缩写/术语 | 全称 | 这里是什么意思 |
|---|---|---|
| LLM | Large Language Model,大语言模型 | 自回归预测下一个 token 的大参数模型;本项目 0.1B 是小型研究基座。 |
| B / 0.1B | Billion,十亿 | 0.1B 参数约一亿个可学习数;本项目精确计数为 100,679,424(词表 8192)。 |
| Corpus | 语料库 | 用来训练的文本集合。demo 是合成文本,不能证明通用语言能力。 |
| Raw dump | 原始数据转储 | 未清洗的文本记录;本项目先统一为每行一条记录的 JSONL。 |
| JSONL | JSON Lines | 一行一个 JSON 对象;字段 text/source/license 表示文本、来源、许可。 |
| Train / Validation / Test | 训练 / 验证 / 测试集 | train 用来更新参数;val 调超参和看 loss;test 最后评估,不能偷偷用于训练。 |
| Leakage | 数据泄漏 | 训练内容与评测内容重复,导致成绩看起来虚高。 |
| Tokenizer | 分词器/编码器 | 把字符串转成 token ID,也能反向解码。 |
| BPE | Byte Pair Encoding,字节对编码 | 反复把高频相邻 token 合并;本项目从 UTF-8 字节开始手写。 |
| UTF-8 | Unicode Transformation Format, 8-bit | 把中英文等字符表示成字节序列;byte-level BPE 可覆盖任意 UTF-8 输入。 |
| Vocabulary / vocab | 词表 | ID 到 token 片段的映射;--vocab-size 512 是教学版。 |
| EOS / PAD | End of Sequence / Padding | 文档结束标志 / 补齐标志;EOS ID=256,PAD ID=257。 |
| Transformer | 基于注意力的神经网络架构 | 本项目是只看左侧上下文的 decoder-only 模型。 |
| Causal attention | 因果注意力 | 第 t 个位置不能偷看 t 后面的 token。 |
| RoPE | Rotary Position Embedding,旋转位置编码 | 把 token 位置注入注意力的 Q/K。 |
| RMSNorm | Root Mean Square Normalization,均方根归一化 | 稳定中间激活的尺度。 |
| SwiGLU | Swish-Gated Linear Unit,门控前馈结构 | Transformer block 的非线性部分。 |
| Q/K/V | Query / Key / Value,查询/键/值 | 注意力的三个投影;Q 与 K 算权重,权重再汇总 V。 |
| SDPA | Scaled Dot-Product Attention,缩放点积注意力 | PyTorch 内置注意力路径;训练用它,Triton kernel 与它做 forward 对照。 |
| Logits | 未归一化分数 | 模型对词表中每个下一个 token 给出的分数。 |
| Softmax | 指数归一化 | 把 logits 变成概率。 |
| Cross-entropy / CE | 交叉熵 | 正确下一个 token 被预测得越准,loss 越低。 |
| Backpropagation | 反向传播 | 用 loss 对参数求梯度。 |
| AdamW | Adam with decoupled Weight Decay | 本项目更新参数的优化器。 |
| Step | 优化一步 | 累积若干 micro-batch 后做一次参数更新;不是一个 token。 |
| Batch / global batch | 批次 / 全局批次 | 一次优化总共用多少训练样本/token;多卡要算所有卡和累积步。 |
| Context window | 上下文窗口 | 模型单次看到的最长 token 数;tiny=128,base100m=1024。 |
| Checkpoint | 检查点 | .pt 文件,保存模型参数及配置;能重新载入推理或继续后训练。 |
| GPU / VRAM | Graphics Processing Unit / Video RAM | 显卡及显存;本机 Intel 核显不提供 NVIDIA CUDA。 |
| CUDA | Compute Unified Device Architecture | NVIDIA GPU 的计算平台;torch.cuda.is_available() 必须为 True 才走本项目 GPU 路径。 |
| Triton | GPU kernel 编程语言/编译器 | 手写注意力 forward 的工具,需兼容的 GPU 环境。 |
| Kernel | GPU 核函数 | GPU 上并行执行的一小段计算程序;这里不是操作系统内核。 |
| DDP | Distributed Data Parallel,分布式数据并行 | 每卡一份模型,各算不同数据,反向时同步梯度。 |
torchrun |
PyTorch distributed launcher | 启动多个训练进程,通常一张 GPU 一个进程。 |
| Throughput | 吞吐量 | 每秒处理多少训练 token / 生成 token。 |
| Latency | 延迟 | 一个请求从开始到拿到结果的时间;更多 GPU 不一定让单请求更快。 |
| FLOPs | Floating-Point Operations,浮点运算次数 | 计算量单位;GPU-hours 是费用/时间单位,两者不能混用。 |
| Scaling law | 缩放规律 | 用不同参数量 N、数据量 D 的实验拟合 loss 变化,检验外推误差。 |
| SFT | Supervised Fine-Tuning,监督微调 | 给问题和正确回答,让模型学习回答 token。 |
| DPO | Direct Preference Optimization,直接偏好优化 | 给同一问题的优/劣两个回答,优化模型对两者的相对偏好。 |
| RLVR | Reinforcement Learning with Verifiable Rewards,可验证奖励强化学习 | 模型先生成,再由确定性规则给奖励;本项目是简化 on-policy REINFORCE,不是完整 PPO/GRPO。 |
| PPO / GRPO | Proximal Policy Optimization / Group Relative Policy Optimization | 两类策略优化算法;本项目借用组内奖励基线思路,但没有实现完整 GRPO。 |
| Verifier | 验证器 | 独立规则,例如答案是否严格等于整数标准答案。 |
| Agent | 智能体 | 读取环境观察、输出 action、接收反馈并继续。 |
| Trajectory / horizon | 轨迹 / 任务步长 | 多步行动记录 / 一局需完成的步数。 |
| Harness | 实验驱动与评测框架 | 自动重置环境、运行多局、记录 action/奖励/成功率的代码。 |
| Self-judge | 自我评判 | 模型为自己生成的候选 action 打分;最终真假仍由环境 verifier 决定。 |
三、从 PowerShell 开始:本机环境
- 打开 Windows PowerShell,进入项目目录:
powershell
   Set-Location 'I:\sideprojects\ai fundamental'
   Get-Location
应看到: 路径是 I:\sideprojects\ai fundamental。如果不是,后面的相对路径命令会找不到文件。
- 本机已有
.venv;直接用其 Python,避免系统 Anaconda 里损坏的torch:
powershell
   .\.venv\Scripts\python.exe -c "import torch; print(torch.__version__, torch.cuda.is_available())"
   .\.venv\Scripts\python.exe -m pytest -q
本机实测: 2.4.1+cpu False;18 passed, 1 skipped。False 表示 CUDA 不可用。skipped 不是通过。如果 .venv 被删,按 README 的安装步骤重建。
- 查看具体跳过原因:
powershell
   .\.venv\Scripts\python.exe -m pytest -rs -q
应看到: CUDA GPU required。你无需在这台机器寻找 Triton 加速结果。
四、第 0 站:自己制造一小份 raw dump,并清洗
入口: fundamental.demo_data → fundamental.data。输入接口: raw/demo.jsonl,每行 text/source/license。输出接口: clean/*.jsonl、clean/manifest.json。
.\.venv\Scripts\python.exe -m fundamental.demo_data --out raw/demo.jsonl
Get-Content raw\demo.jsonl -TotalCount 2
.\.venv\Scripts\python.exe -m fundamental.data --input raw/demo.jsonl --out clean --licenses CC0
Get-Content clean\manifest.json
本机实测: raw 1500 条;清洗后 train 1467、val 18、test 15。这里没有重复项和许可排除项。你改动 raw 文件后计数可能变化。--licenses CC0 表示只允许标注为 CC0 的记录进入语料。
你要理解: 清洗程序先规范化文本,再做精确/近重复过滤,最后按文本哈希稳定切分。训练 tokenizer 时只读 clean/train.jsonl,避免从验证集学习词表。
五、第 1 站:手写 BPE,把文字变成数字
入口: fundamental.tokenizer train|encode|pack。输入: clean/train.jsonl;输出: tokenizer.json、tokens/{train,val,test}.bin、tokens/manifest.json。
.\.venv\Scripts\python.exe -m fundamental.tokenizer train --input clean/train.jsonl --out tokenizer.json --vocab-size 512
.\.venv\Scripts\python.exe -m fundamental.tokenizer encode --tokenizer tokenizer.json 'Hello 世界'
.\.venv\Scripts\python.exe -m fundamental.tokenizer pack --tokenizer tokenizer.json --input-dir clean --out tokens
Get-Content tokens\manifest.json
应看到: vocab_size: 512;encode 打印整数 ids 和 roundtrip: Hello 世界。本机 pack 结果 train 45,586 tokens、val 560、test 466。.bin 是 little-endian uint16 原始整数流,程序边编码边写盘,不把全部 token 放进内存。
动手改一个变量: 把词表改成 258,重新 pack 到另一个目录,比较 train token 数。词表越小通常切得越碎。不要用不同 tokenizer 读取已有 checkpoint:token ID 含义已经变了。
六、第 2 站:模型结构与参数量
入口: fundamental.model;输入: 配置名、词表大小;输出: 参数计数和 tiny 前向/反向检查。
.\.venv\Scripts\python.exe -m fundamental.model --config tiny --vocab-size 512
.\.venv\Scripts\python.exe -m fundamental.model --config base100m --vocab-size 8192
本机实测: tiny = 1,115,264 参数;base100m = 100,679,424 参数。第二条命令只创建模型并数参数,没有训练 0.1B。
看代码顺序: GPTConfig → RMSNorm → apply_rope → Attention → Block → GPT.forward。输入张量形状通常是 [batch, time] 的整数 ID;输出 logits 形状是 [batch, time, vocab_size]。因果性测试会改后面的 token,检查前面位置的输出保持不变。
七、第 3 站:CPU 上做一个真正的 tiny 训练短跑
入口: fundamental.train;输入: token .bin、tokenizer.json、训练参数;输出: base.pt 和 metrics.jsonl。
.\.venv\Scripts\python.exe -m fundamental.train --data tokens --tokenizer tokenizer.json --config tiny --batch-size 1 --seq-len 32 --steps 20 --eval-every 10 --out runs/lesson_tiny
Get-Content runs\lesson_tiny\metrics.jsonl
Get-Item runs\lesson_tiny\base.pt | Select-Object Name,Length
应看到: 第 10、20 步各一条 JSON;最终 tokens_seen = 20 × 1 × 32 = 640。train_loss_rank0 是训练抽样 loss,val_loss 是未参与更新的验证文本 loss;下降与否要看实际日志。约 4 MB 的 base.pt 供推理使用;latest.pt 另存优化器和采样器状态供恢复。640 token 远远不足以学会语言。
解释三个参数: --batch-size 1 每个 micro-step 取 1 段;--seq-len 32 每段 32 个输入 token;--steps 20 更新 20 次。若指定 --global-tokens,程序会用梯度累积凑足每次更新的总 token 数。
八、现在就体验模型:终端输入一句话
当前工作区已有 runs/chat_toy.pt,它由早期 tiny checkpoint 加 4 句玩具 SFT 训练得到。先用一次性命令:
.\.venv\Scripts\python.exe -m fundamental.chat --checkpoint runs/chat_toy.pt --tokenizer tokenizer.json --once hello
.\.venv\Scripts\python.exe -m fundamental.chat --checkpoint runs/chat_toy.pt --tokenizer tokenizer.json --once '2+2?'
本机实测: 第一条输出 Hi!,第二条输出 4。进入持续输入模式:
.\.venv\Scripts\python.exe -m fundamental.chat --checkpoint runs/chat_toy.pt --tokenizer tokenizer.json
终端显示 You>,输入 what is your name?,本机实测输出 I am TinyBot.;输入 /exit 退出。--history 可以保留短对话历史,但 tiny 上下文只有 128 token,超长历史会被清掉。没教过的 how are you? 本机输出 I I TinyBot.,说明它主要在记忆四句训练样本。
想亲自重训这个演示:
.\.venv\Scripts\python.exe -m fundamental.demo_chat --out tasks/chat_toy.jsonl
Get-Content tasks\chat_toy.jsonl
.\.venv\Scripts\python.exe -m fundamental.posttrain sft --base runs/lesson_tiny/base.pt --data tasks/chat_toy.jsonl --tokenizer tokenizer.json --out runs/my_chat_toy.pt --steps 200 --lr 0.0003
.\.venv\Scripts\python.exe -m fundamental.chat --checkpoint runs/my_chat_toy.pt --tokenizer tokenizer.json --once hello
接口解释: 每个训练样本有 prompt 和 completion;SFT 只对 completion 的 token 算目标 loss。chat.py 把你的输入包装成 User: ...\nAssistant:,反复调用模型生成直到 EOS 或长度上限。temperature=0 默认取最高分 token,结果可重复;增大温度才采样,更随机。
九、第 4 站:注意力 kernel 与 CUDA 检查(租 GPU 后执行)
本机先读 fundamental/triton_attention.py,重点看 QK 分块、因果遮罩、online softmax 的 m/l/acc 更新。该代码只实现 forward,反向训练仍走 PyTorch SDPA。
租到 NVIDIA GPU 后,在 Linux 终端执行:
nvidia-smi
python -c "import torch; print(torch.__version__, torch.cuda.is_available(), torch.cuda.get_device_name())"
python -m pip install triton
python -m pytest -q tests/test_triton_attention.py
python -m fundamental.bench attention --seq-len 512 --out runs/attention_gpu.jsonl
验收顺序: torch.cuda.is_available() 为 True → 6 个测试 passed → benchmark 打印 max_abs_error、sdpa_ms、triton_ms、triton_speedup。speedup > 1 才表示在该 GPU/形状上比 SDPA 快;< 1 也是真实结果。通过数值测试不能替代计时。
十、第 5 站:scaling law 要怎样真正拟合
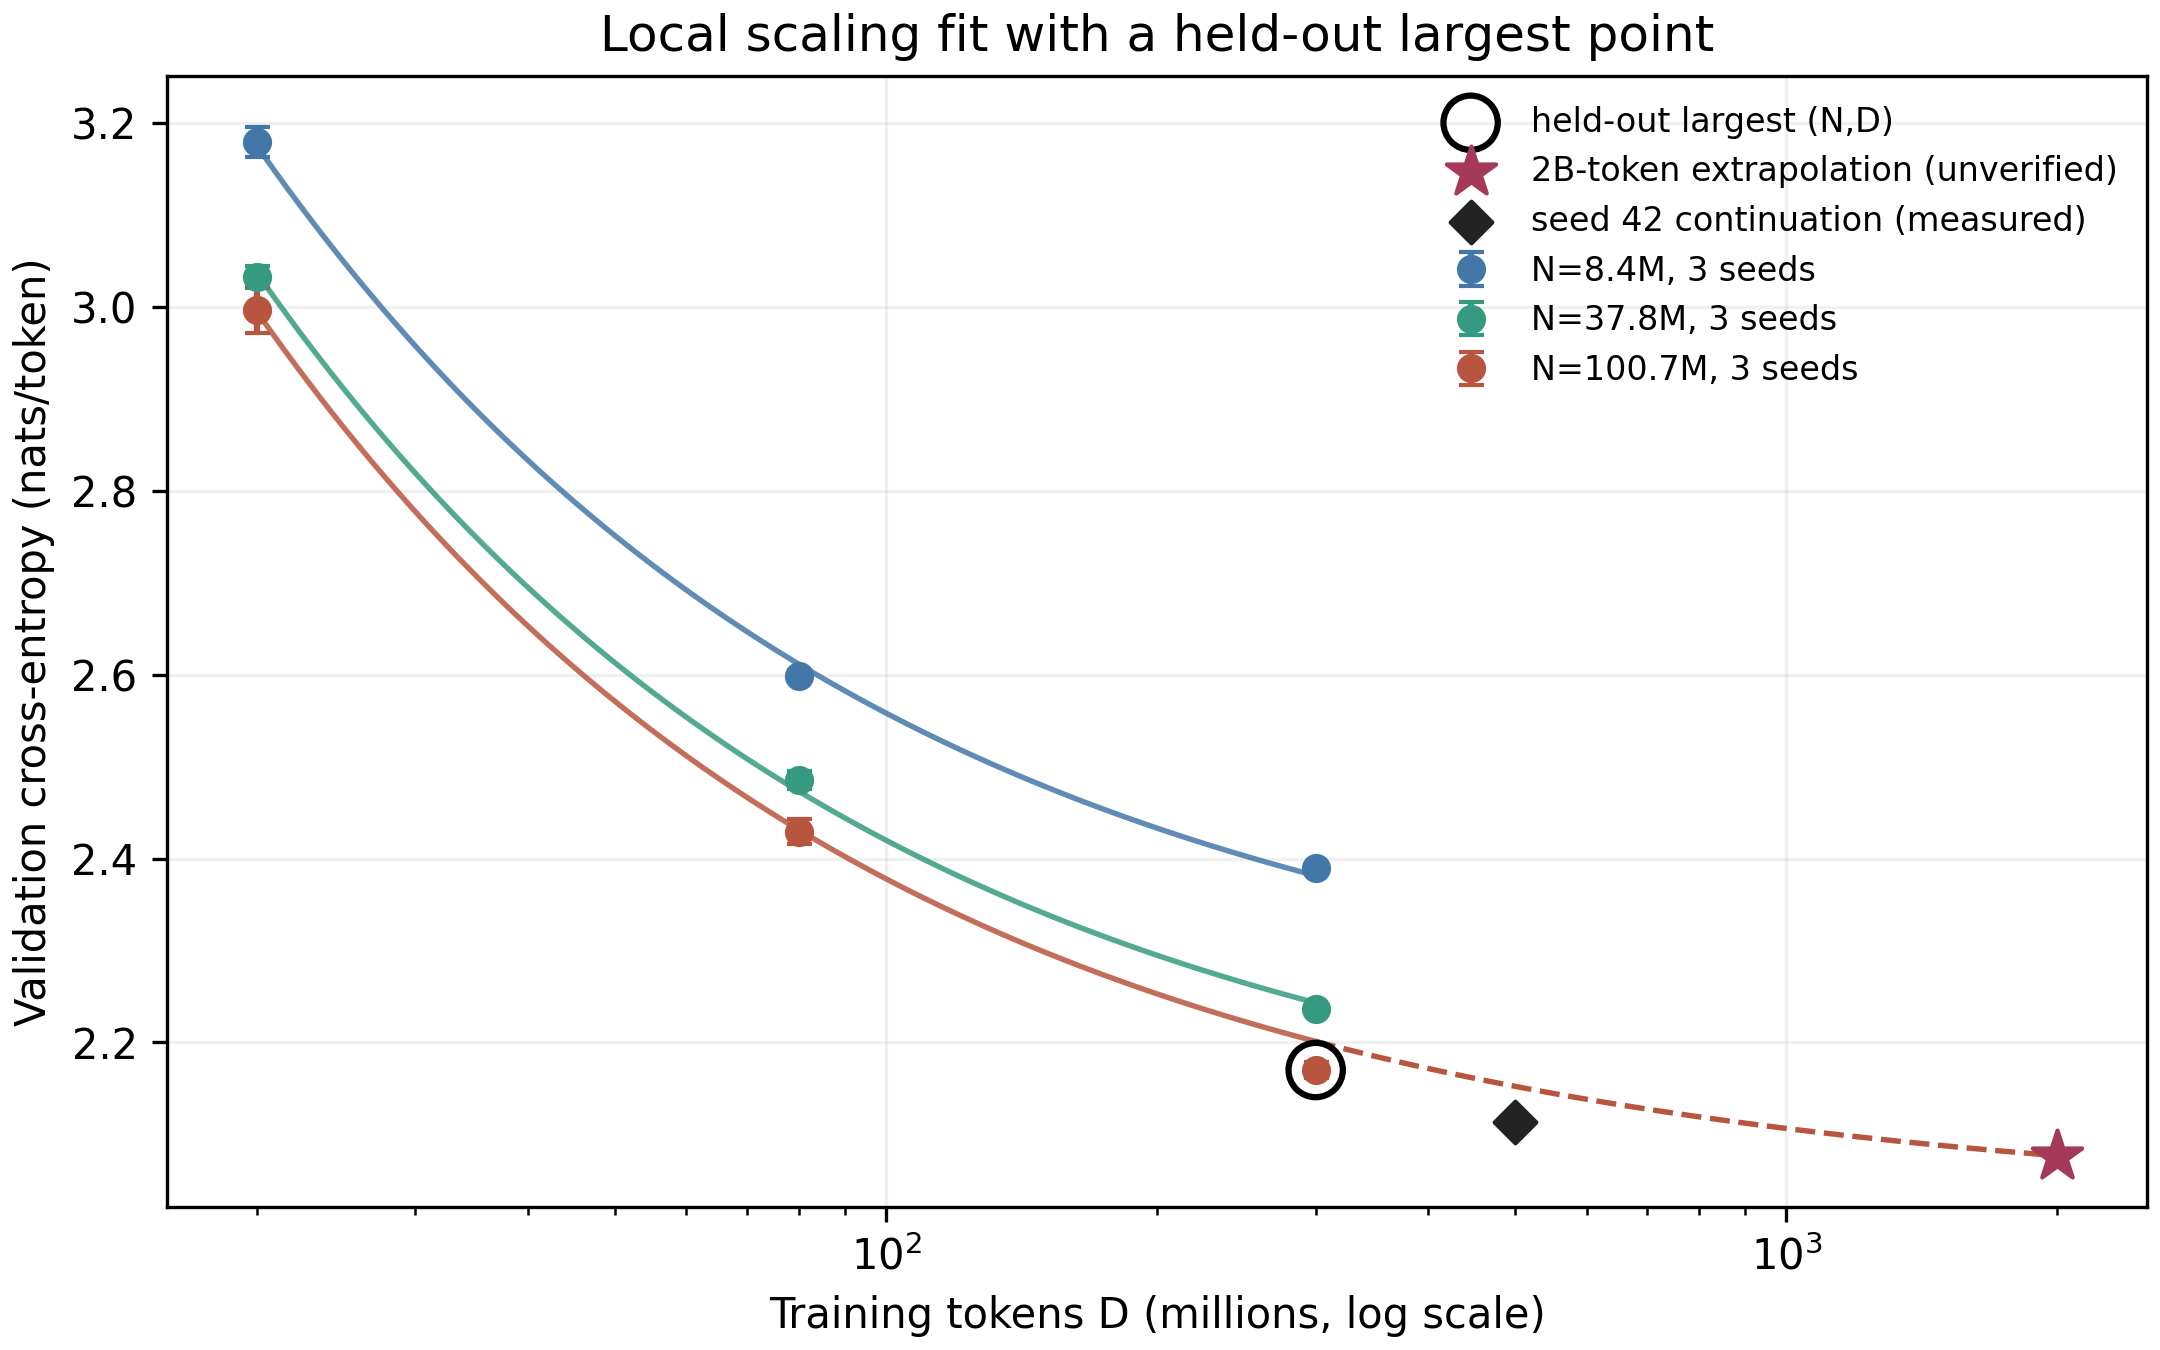
接口: scripts.analyze_scaling_grid --grid 网格目录 --out 拟合结果.json。每个训练记录里的 params=N 是参数量,tokens_seen=D 是累计训练 token,val_loss=L 是验证集的平均下一 token 交叉熵。实验固定 tokenizer、语料、验证采样、上下文长度和每步全局 token;最大规模的一个 (N,D) 组合留出,只用于检验拟合预测。
正式 small/medium/base100m 三种配置、各三个随机种子,已在 RTX 4090 上全部完成。每条运行在约 20M、80M、300M token 各记录一次验证损失。你可在 AutoDL 终端重算:
python -m scripts.analyze_scaling_grid --grid /root/autodl-tmp/runs/scaling_grid_v2 --out /root/autodl-tmp/runs/scaling_grid_v2/scaling_fit.json --target-tokens 2000000000 --bootstrap-samples 200
应看到: E,A,B,alpha,beta、fit_rmse、留出点的 actual_loss/predicted_loss/absolute_error,以及按每个模型的三条随机种子轨迹重采样得到的预测区间。程序会先核对九条运行是否全完成;未完成会报错并停止。2B token 超过这张 grid 的 300M token 上限,所以即使留出点误差小,2B 预测仍是高风险外推,需要用后续实际训练的验证损失检验。区间只反映这三个随机种子的波动,不包含数据源、模型结构或拟合函数选择的不确定性。
本次实测: 预留的最大模型、300M token 那一格,三个随机种子的平均验证损失为 2.16986;只看其他八格的拟合预测 2.20104,相差 0.03118。向同一模型的 2B token 外推预测 2.07661,目前只是预测。你可打开 拟合图:彩色点是三种模型的验证损失,黑圈是预留点,最右侧星号是尚待实测的 2B 预测。原始数据、随机种子和拟合参数在 scaling_fit.json。
十一、第 6 站:SFT / DPO / RLVR 对照
先生成教学任务:
.\.venv\Scripts\python.exe -m fundamental.posttrain make-data --out tasks
Get-Content tasks\sft.jsonl -TotalCount 1
Get-Content tasks\dpo.jsonl -TotalCount 1
Get-Content tasks\rlvr.jsonl -TotalCount 1
你会看到: SFT 有 prompt/completion;DPO 有 prompt/chosen/rejected;RLVR 有 prompt/answer,answer 只交给 verifier,不喂给模型生成。
为了几分钟内检查管线,可用下面的短跑;这不是效果实验:
.\.venv\Scripts\python.exe -m fundamental.posttrain sft --base runs/lesson_tiny/base.pt --data tasks/sft.jsonl --tokenizer tokenizer.json --out runs/lesson_sft.pt --steps 20
.\.venv\Scripts\python.exe -m fundamental.posttrain dpo --base runs/lesson_sft.pt --data tasks/dpo.jsonl --tokenizer tokenizer.json --out runs/lesson_dpo.pt --steps 20
.\.venv\Scripts\python.exe -m fundamental.posttrain rlvr --base runs/lesson_sft.pt --data tasks/rlvr.jsonl --tokenizer tokenizer.json --out runs/lesson_rlvr.pt --steps 20
结果在哪里: 每条命令生成 .pt checkpoint 和同名 .jsonl 日志。DPO 初始 margin 可能为 0、loss 约 0.693;RLVR 日志可能出现 skipped_zero_variance: true,表示同组候选全错/全对,没有可比较的奖励,训练被跳过。没有更新就不能声称 RLVR 学到了东西。
统一评测入口:
Get-Content tasks\eval.jsonl -TotalCount 5 | Set-Content tasks\eval_first5.jsonl
.\.venv\Scripts\python.exe -m fundamental.evaluate --checkpoints runs/lesson_tiny/base.pt runs/lesson_sft.pt runs/lesson_dpo.pt runs/lesson_rlvr.pt --tokenizer tokenizer.json --data tasks/eval_first5.jsonl --out runs/lesson_eval.json
应看到: 每个分支的 n/correct/accuracy/wilson95。5 题只是接口检查;正式结论应评测全部 held-out 题、多个 seed,并计入 SFT、DPO、RLVR 不同的生成和训练成本。
十二、第 7 站:长程 Agent、verifier 与 self-judge
环境每步给当前整数和下一检查点,模型必须输出严格的 ADD n。不符合格式或到错检查点立刻失败;一局连续成功才算完成。horizon=4 是 4 步,不是 4 个 token。
.\.venv\Scripts\python.exe -m fundamental.agent collect --out tasks/agent_oracle.jsonl --episodes 20 --horizon 4
Get-Content tasks\agent_oracle.jsonl -TotalCount 2
.\.venv\Scripts\python.exe -m fundamental.agent train --base runs/lesson_tiny/base.pt --tokenizer tokenizer.json --data tasks/agent_oracle.jsonl --steps 50 --out runs/lesson_agent.pt
.\.venv\Scripts\python.exe -m fundamental.agent eval --base runs/lesson_agent.pt --tokenizer tokenizer.json --episodes 10 --horizon 4 --out runs/lesson_agent_eval.jsonl
输出: oracle 文件有 prompt/completion/seed/step;评测 JSONL 每行一局,含每步 observation/action/环境结果。终端打印 successes/success_rate。训练仅 50 步时成功率可能是 0,属于正常观察。
自评开关对照:同 checkpoint、同 --seed、同 --episodes,只改变候选排序:
.\.venv\Scripts\python.exe -m fundamental.agent eval --base runs/lesson_agent.pt --tokenizer tokenizer.json --episodes 10 --horizon 4 --seed 100000 --candidates 3 --out runs/agent_plain.jsonl
.\.venv\Scripts\python.exe -m fundamental.agent eval --base runs/lesson_agent.pt --tokenizer tokenizer.json --episodes 10 --horizon 4 --seed 100000 --self-judge --candidates 3 --out runs/agent_judge.jsonl
两次评测现在都采样 3 个候选:关闭 self-judge 时选第一个,开启时由模型给三个候选打分再选最高者。这样候选生成预算一致;仍需单独报告 judge 的额外计算与总决策时间。judge_scores 是模型自己的猜测,不是奖励真值;环境 valid/success 才是真值。在线训练入口 python -m fundamental.agent rl --base runs/lesson_agent.pt ... 建议在 imitation 能完成一部分局后再用。
十三、租什么 GPU、如何具体操作
先选卡,再付款
以 2026-10-01 查询到的页面挂牌价 为参考,不保证你下单时、地区和空闲机器的实际价格。中国大陆新手优先考虑 AutoDL 算力市场:中文界面、JupyterLab、按量计费。其页面列出的 RTX 3090 24GB ¥1.32/时、RTX 4090 24GB ¥1.88/时、A800 80GB ¥5.59/时。本项目 0.1B 模型建议先选 单张 4090 做 kernel 与短训练;3090 更便宜,4090 的时间成本可能更好,最终用实际 tokens/s 和总费用比较。多卡实验再找同一台主机的 2/4 张相同 GPU,不要先买多卡长时套餐。AutoDL 价格页、创建实例教程。
另一选择是 Runpod Pods:页面列出 RTX 3090 $0.50/时、4090 $0.74/时、A100 80GB $1.59/时,另有存储费用;美元支付和跨境数据传输是否方便需自己确认。它的 官方部署说明 是选 GPU、地区、镜像后部署 Pod。Vast.ai 是动态报价市场,官方说明提示供应和竞价会改变价格;纯新手先用明确挂牌价的平台更容易控制变量。
AutoDL 第一次租单卡:逐步点击
- 到 AutoDL 注册,先看实时价格、机器空闲数、磁盘容量和计费方式;只为一次短测试准备预算。按 官方快速开始进入「控制台 → 我的实例 → 租用新实例」。
- 选按量计费、1× RTX 4090 24GB、带 CUDA PyTorch 的 Linux 基础镜像、足够系统盘/数据盘。先做代码短跑不必下载 28.5 GB 数据;当前两个正式 Parquet 分片及中间结果放在 50 GB 数据盘,需持续检查剩余空间并清理临时 checkpoint。确认页面上显示的最终每小时单价和硬盘收费,再创建。
- 状态为「运行中」后点击 JupyterLab → Terminal。先运行
nvidia-smi与python -c 'import torch; print(torch.cuda.is_available())'。只有 True 才继续。 - 在本机项目目录打包源码,不含
.venv与旧训练文件:
powershell
   Compress-Archive -Path fundamental,tests,report,README.md,LESSONS.md,BEGINNER_TUTORIAL.md,requirements.txt -DestinationPath project.zip -Force
用 JupyterLab 的上传按钮上传 project.zip;官方快速开始也提供了上传说明。云端终端:
bash
   mkdir -p ~/ai-fundamental
   unzip project.zip -d ~/ai-fundamental
   cd ~/ai-fundamental
   python -m pip install -r requirements.txt
   python -m pip install triton
   python -m pytest -q tests/test_triton_attention.py
- 用 demo 先跑第 0–3 站的命令,最后做 GPU attention benchmark。确认环境可用后及时关机;AutoDL 计费规则说明实例运行时按秒计费,关机停止 GPU 计费,磁盘可能另计,实例数据有保留期限。
再考虑真实 0.1B 语料
demo 的 train 只有 45,586 tokens,远远不够。可研究 FineWeb-Edu sample-10BT:官方数据卡标注 ODC-BY,约 10B GPT-2 tokens,样本文件合计约 28.5 GB。它主要是英文网页文本;要训练中文模型需另找合适语料,且应检查数据许可、清洗质量与个人信息风险。云端可先导入一个小子集测试数据接口:
python -m pip install datasets
python -m fundamental.import_hf --dataset HuggingFaceFW/fineweb-edu --config sample-10BT --split train --license odc-by --max-docs 10000 --out raw/fineweb_10k.jsonl
python -m fundamental.data --input raw/fineweb_10k.jsonl --out clean --licenses odc-by
python -m fundamental.tokenizer train --input clean/train.jsonl --out tokenizer.json --vocab-size 8192 --max-bytes 20000000
python -m fundamental.tokenizer pack --tokenizer tokenizer.json --input-dir clean --out tokens
cat tokens/manifest.json
应看到: 成功导出文档、清洗计数、train/val/test token 数。10,000 文档是管线检查,不一定够训练 0.1B。完整实验需扩大数据、检查 train token 数是否足够,并预留原文和 token 文件的磁盘空间。手写 Python BPE 和清洗器是可读参考实现,大语料可能很慢;先测实际耗时,再决定是否优化。
先估价,不要直接跑 2B tokens
在单卡上做与正式配置相同形状的短跑,例如:
python -m fundamental.train --data tokens --tokenizer tokenizer.json --config base100m --batch-size 2 --seq-len 1024 --global-tokens 131072 --steps 20 --eval-every 20 --out runs/pilot_100m
tail -1 runs/pilot_100m/metrics.jsonl
读 train_tokens_per_s。假设要训练 2,000,000,000 token,预估小时数约为「目标 token 数 ÷ 实测 tokens/s ÷ 3600」,费用约为「小时数 × 当前每小时价格」;再加数据准备、验证和失败重跑。必须用你租到的机器实测 tps,不能拿显卡峰值 TFLOPS 当训练吞吐。若 demo 数据不足,长训练会反复看相同文本,不能算有效 2B 新 token。
正式长跑加 --eval-every 200 --save-every 200,每 200 步写一次可恢复的 latest.pt。中断后原命令保持 GPU 数、batch、seq、tokenizer、输出目录相同,再加 --resume runs/正式目录/latest.pt;--steps 填最终总步数。本机验证了 1 步保存→恢复到 2 步,与连续跑 2 步的模型权重完全一致(最大差异 0)。这个验证只覆盖单机 CPU 的 tiny 路径;GPU 多卡恢复仍需在租赁环境检查。
多卡究竟看什么结果
在同一宿主机、同样的 token 数据、配置、全局 batch 和累计 token 数下分别跑 1 卡、4 卡,保存各自 metrics.jsonl。然后:
python -m fundamental.compare --kind train --single runs/train_1gpu/metrics.jsonl --multi runs/train_4gpu/metrics.jsonl --out runs/train_speedup.json
python -m fundamental.compare --kind inference --single runs/infer_1gpu.jsonl --multi runs/infer_4gpu.jsonl --out runs/infer_speedup.json
输出 speedup 和 parallel_efficiency。例如 4 卡 throughput 是 1 卡的 3 倍,则效率 3/4=75%;这是算式示例,不是本项目实测结果。推理代码把多个请求分给多卡、每卡各一份模型,测的是总吞吐;它没有 KV cache,不能代表生产推理延迟。
十四、最终报告怎样从“草稿”变成研究结果
打开 NeurIPS 风格报告草稿。每一个结果行填:数据来源/许可证、模型和 tokenizer hash、GPU 型号、PyTorch/Triton 版本、命令与 seed、训练 token、wall time、GPU-hours、loss/正确率/成功率、置信区间、失败或跳过实验。先收集原始 JSONL,再画图和写结论。没有 GPU 测试数据时,Triton 和多卡表格必须保持「待测」。
建议的学习节奏: 第一轮只做本机第 0–3 站和聊天体验;第二轮理解后训练与 Agent 的数据格式;第三轮租一张 4090 做 CUDA 正确性与短跑;第四轮再决定是否值得花钱做 0.1B 完整训练和多卡对照。
十五、你当前这台 AutoDL 4090 实例:按真实产物逐站验收
以下命令在 AutoDL 的 JupyterLab → Terminal 输入,一条一条运行。终端提示符应以 ~/ai-fundamental# 结尾;如果不在项目目录,先运行 cd ~/ai-fundamental。数据放在 /root/autodl-tmp,而不是 JupyterLab 左侧文件浏览器默认的 /root。
| 站点 | 你输入的命令 | 应看到什么 | 代表什么 |
|---|---|---|---|
| 0 原始语料清洗 | cat /root/autodl-tmp/corpus/clean/manifest.json |
raw 1,455,000;train 1,416,623;val 14,396;test 14,580 | 已做来源过滤、去重和固定切分,不表示模型已经训练 |
| 1 分词器 | python -m fundamental.tokenizer encode --tokenizer /root/autodl-tmp/corpus/tokenizer_8192.json 'Hello, world!' |
一个整数 ID 列表和 roundtrip: Hello, world! |
编码后能解码回来;ID 不是英文单词编号 |
| 1 全量编码 | cat /root/autodl-tmp/corpus/tokens_8192/manifest.json |
train 2,685,790,665;val 27,400,609;test 27,098,920 token | 正式训练集已足够做约 2B token 的抽样训练 |
| 2 模型规模 | python -m fundamental.model --config base100m --vocab-size 8192 |
100,679,424 parameters | 只建立模型并数参数,不是训练结果 |
| 3 训练状态 | tail -2 /root/autodl-tmp/runs/scaling_grid_v2/small_seed42/metrics.jsonl |
JSON 中有 step/tokens_seen/val_loss/train_tokens_per_s |
一条记录对应一次固定验证,数值会随训练更新 |
| 硬件状态 | nvidia-smi |
RTX 4090、显存占用和 GPU 利用率 | 能看到 GPU 被训练进程使用;显存占用不等于速度 |
| 磁盘 | df -h /root/autodl-tmp |
50G 数据盘及可用空间 | checkpoint 会占空间,剩余空间过低需处理 |
正式 scaling grid 的九条运行已经结束。当前后台作业是同一 base100m seed 42 从 300M 续训至约 2B token。查看进程与 GPU:
ps -eo pid,etime,cmd | grep '[f]undamental.train'
nvidia-smi
tail -2 /root/autodl-tmp/runs/base100m_2b_driver.log
df -h /root/autodl-tmp
应看到: 第一条有一个 --out /root/autodl-tmp/runs/base100m_2b 的 Python 进程,nvidia-smi 显示 RTX 4090 正在工作;日志在计划的约 500M、1B、2B token 验证点才会打印一条 JSON,前一段时间空白是正常的。若进程消失且日志报错,先检查错误和 latest.pt,不要直接新开第二个训练进程。用 tail -f 跟随日志后按 Ctrl+C 只退出查看命令,不会停止后台训练。
当前第一个长训结果: step=61035 对应 499,998,720 token,val_loss=2.11379,比同一 seed 在 300M token 时的 2.17908 低。它说明这段训练继续降低固定验证集上的下一 token 损失;不能据此认为模型已会正确回答算术题或可以流畅聊天。剩下的 1B、2B 点仍要等后台进程跑到相应步数。
正式 grid 全部统一 seq_len=1024、global_tokens=8192、单卡 batch_size=8,所以每个优化 step 恰好处理 8×1024=8192 个输入 token。tokens_seen=step×8192。val_loss 是模型预测未用于更新的验证 token 的平均交叉熵,越低通常越好;它不是问答正确率。train_tokens_per_s 是上一个验证区间的训练吞吐,数值受 GPU/CPU、存盘、热状态影响;一次短跑不足以决定稳态速度。
要直接体验训练好的模型,等正式 base.pt 生成后运行下面的原文续写入口。预训练基座只学预测下一个 token,通常不懂 User/Assistant 聊天格式;--raw 会把你的输入原样送给模型:
python -m fundamental.chat --checkpoint /root/autodl-tmp/runs/base100m_2b/base.pt --tokenizer /root/autodl-tmp/corpus/tokenizer_8192.json --raw --once 'The scientific method is' --max-new-tokens 50
如果当前尚无 base100m_2b/base.pt,请等该阶段训练完成;不要把 20 步 probe 的 base.pt 当正式语言模型。以后算术 SFT 完成,可以把 --checkpoint 改成 SFT 文件,试 --raw --once 'Compute 7 + 5. Answer: ';这仍是窄领域练习,不是通用聊天助手。纯聊天交互可先用第八节的玩具模型学习界面。
JupyterLab 突然显示 404 时
- 在 AutoDL 控制台登录你自己的账户,打开「容器实例」,找到这台 RTX 4090 实例;先看状态是运行中、关机还是已释放,并查看账户余额。404 只表示旧访问地址当前不可用,不能单凭它判断数据丢失或训练失败。密码与 Jupyter Token 不要发到聊天。
- 如果实例运行中,从该实例页面重新点 JupyterLab,使用新打开的地址。若实例关机且余额足够,启动原实例,等它变为运行中再点 JupyterLab;启动后后台训练脚本通常不会自动恢复,需要先检查。若已释放,先核对数据盘/镜像是否仍可恢复,不要立即租第二台并从头训练。
- 能进入 Terminal 后,逐条执行以下只读命令,把不含凭据的结果保存下来:
cat /root/autodl-tmp/runs/scaling_grid_v2/grid_manifest.json
ps -eo pid,ppid,etime,cmd | grep -E 'run_scaling_grid|fundamental.train' | grep -v grep
nvidia-smi
df -h /root/autodl-tmp
tail -20 /root/autodl-tmp/runs/scaling_grid_v2_supervisor.log
- 如果
fundamental.train还在运行,继续等待原作业。若不在运行,检查 manifest 和对应目录的latest.pt、metrics.jsonl,再从 checkpoint 恢复。不要在确认旧作业已停止之前启动同一 grid 的第二份进程。